Masz wartościową stronę, ale w wynikach Google wygląda jak zwykły niebieski link? Dane strukturalne Google pomagają wyszukiwarce zrozumieć, czy opisujesz artykuł, produkt, firmę, wydarzenie albo nawigację. Wyjaśniam, jak działają, które typy mają sens dla bloga i sklepu, jak je wdrożyć oraz jak sprawdzić, czy nie zawierają błędów.
Najważniejsze informacje o danych strukturalnych
- Cel danych strukturalnych to dokładniejsze opisanie treści strony robotom wyszukiwarki.
- JSON-LD jest obecnie najwygodniejszym formatem wdrożenia dla większości witryn.
- Markup może zwiększyć szansę na wynik rozszerzony, ale nie gwarantuje wyższej pozycji ani jego wyświetlenia.
- Najważniejsze są zgodność z widoczną treścią, kompletność i aktualność informacji.
- Poprawność sprawdzisz w Rich Results Test i raportach ulepszeń w Google Search Console.
Co dają dane strukturalne Google i jak działają
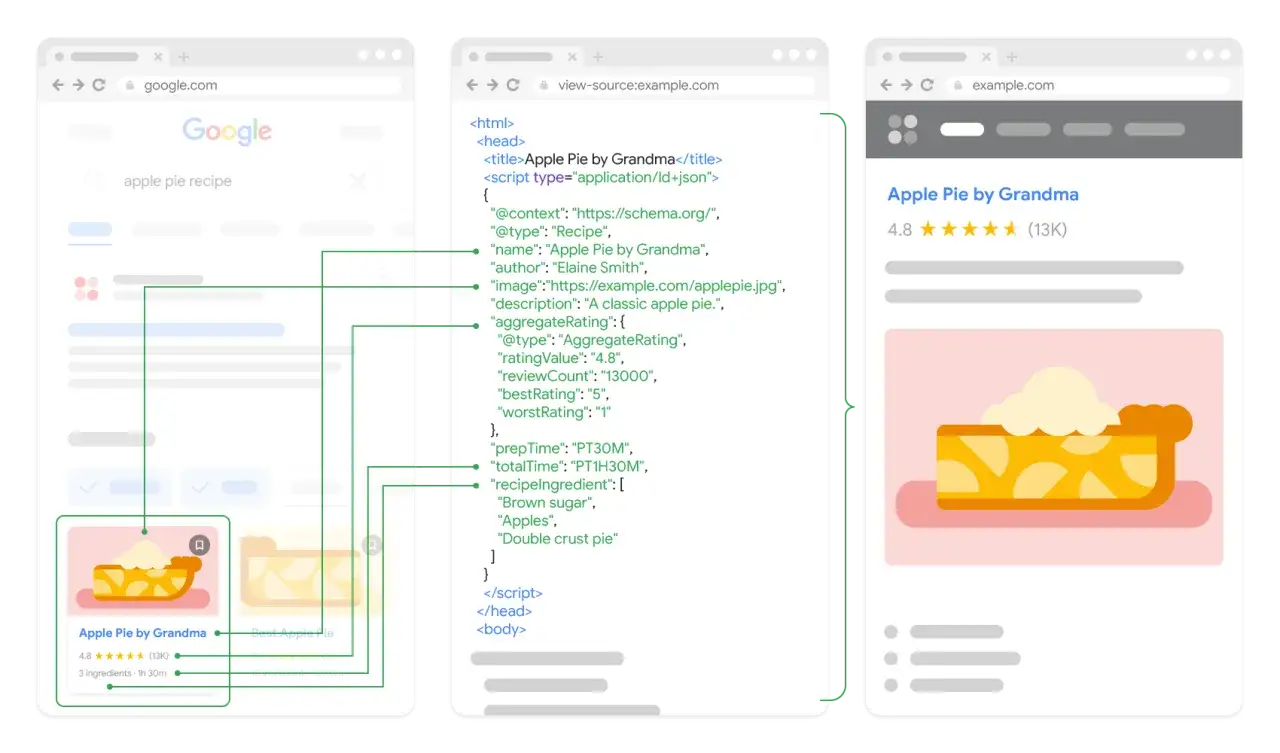
Dane strukturalne to uporządkowane informacje zapisane w kodzie strony. Pokazują wyszukiwarce, czym jest dany element treści, a nie tylko jakie słowa znajdują się na stronie. Dzięki nim Google może łatwiej rozpoznać autora artykułu, cenę produktu, dostępność, ocenę, adres firmy czy położenie strony w strukturze serwisu.
Najprościej wyobrazić je sobie jako etykiety naklejone na treść. Sam tekst „249 zł” nie zawsze wystarcza, by robot wiedział, czy chodzi o cenę produktu, koszt dostawy czy wartość rabatu. Odpowiednie właściwości schema.org doprecyzowują znaczenie tej informacji.
Efektem może być rich result, czyli rozszerzony wynik wyszukiwania z dodatkowymi elementami, na przykład ceną, dostępnością, zdjęciem, oceną lub okruszkami nawigacyjnymi. To poprawia widoczność wyniku i może zwiększyć jego atrakcyjność, ale nie jest magicznym sposobem na awans w rankingu.
To rozróżnienie ma duże znaczenie. Poprawny markup daje stronie możliwość kwalifikacji do określonego formatu wyniku, lecz Google sam decyduje, czy pokaże go dla konkretnego zapytania, urządzenia, lokalizacji i użytkownika. W praktyce traktuję dane strukturalne jako warstwę ułatwiającą interpretację strony, a nie zamiennik dobrej treści, linkowania i technicznego SEO.
Jakie typy danych strukturalnych mają sens
Nie warto dodawać wszystkich dostępnych typów tylko dlatego, że istnieją w słowniku schema.org. Najlepiej zacząć od oznaczeń, które rzeczywiście opisują zawartość strony i mogą wspierać sposób jej prezentacji w Google.
| Typ | Gdzie go stosować | Co może poprawić |
|---|---|---|
| Article lub BlogPosting | Artykuły, poradniki, analizy i wpisy blogowe | Lepsze rozpoznanie tytułu, autora, daty i zdjęcia publikacji |
| BreadcrumbList | Serwisy z kategoriami i wielopoziomową strukturą | Pokazanie ścieżki nawigacyjnej w wynikach |
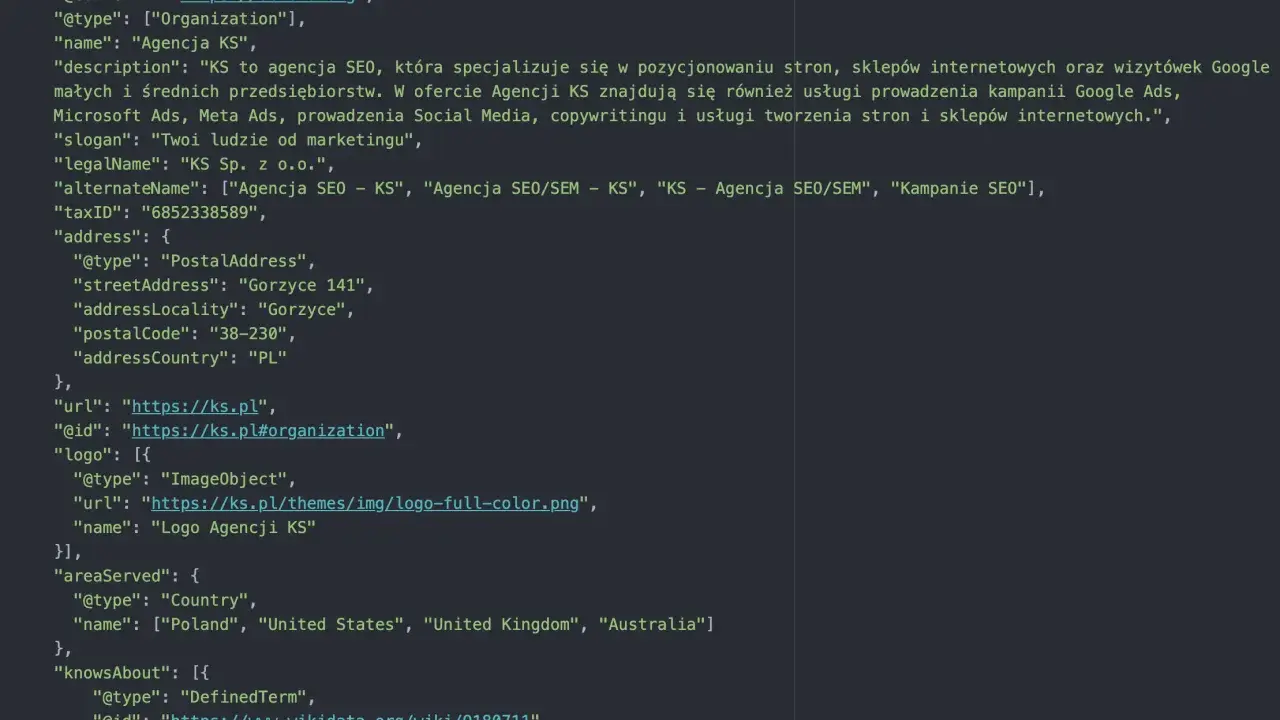
| Organization | Strona główna lub strona opisująca markę | Pomoc w identyfikacji firmy, logo i profili organizacji |
| Product | Karty produktów i strony z ofertą | Prezentację ceny, dostępności, opinii, dostawy i zwrotów |
| LocalBusiness | Firmy obsługujące klientów w konkretnej lokalizacji | Lepsze opisanie danych firmy, adresu i godzin otwarcia |
| Event | Konferencje, szkolenia, koncerty i wydarzenia online | Pokazanie daty, miejsca i informacji o wydarzeniu |
| VideoObject | Strony, na których film jest istotną częścią treści | Ułatwienie rozpoznania tytułu, miniatury i czasu trwania filmu |
W przypadku bloga takiego jak Rosalli.pl zwykle największy sens mają Article lub BlogPosting, BreadcrumbList i Organization. Jeżeli publikacja ma jasno wskazanego autora, można dodatkowo opisać osobę odpowiedzialną za treść. Nie oznacza to jednak, że każda strona powinna otrzymać identyczny zestaw danych.
Ostrożnie podchodzę do oznaczeń opinii i ocen. Nie należy dodawać gwiazdek wyłącznie po to, by przyciągnąć wzrok, jeśli strona nie zawiera prawdziwych, widocznych recenzji. Markup musi odpowiadać temu, co widzi użytkownik, inaczej może nie zostać wykorzystany, a w skrajnym przypadku naruszyć wytyczne Google.
JSON-LD, Microdata czy RDFa
Google obsługuje trzy główne formaty danych strukturalnych: JSON-LD, Microdata i RDFa. Wszystkie mogą być poprawne, ale w nowych wdrożeniach najczęściej wybrałbym JSON-LD, ponieważ oddziela opis semantyczny od widocznego kodu HTML i łatwiej go utrzymać.
JSON-LD
JSON-LD umieszcza się zwykle w elemencie skryptowym w sekcji head albo body dokumentu. Nie trzeba dodawać specjalnych atrybutów do każdego nagłówka czy akapitu, dlatego format dobrze sprawdza się w WordPressie, sklepach internetowych i serwisach tworzonych z użyciem szablonów.
Microdata
Microdata wykorzystuje atrybuty HTML dodawane bezpośrednio do widocznych elementów strony. Rozwiązanie może być wygodne przy prostych projektach, ale przy rozbudowanych treściach szybko staje się trudniejsze w edycji. Zmiana struktury HTML może przypadkiem usunąć część oznaczeń.
Przeczytaj również: Direct answer w SEO - jak odpowiadać konkretnie i skutecznie
RDFa
RDFa również rozszerza kod HTML o informacje semantyczne. Jest użyteczna w niektórych zaawansowanych projektach, lecz dla typowej strony firmowej, bloga albo sklepu zwykle nie daje praktycznej przewagi nad JSON-LD.
Sam format nie rozwiązuje problemu błędnych danych. Można mieć poprawny składniowo JSON-LD, który opisuje nieistniejącą promocję, ukrytą opinię albo treść niezwiązaną z daną podstroną. Jakość i zgodność informacji są ważniejsze niż liczba dodanych właściwości.
Jak wdrożyć dane strukturalne krok po kroku
Najpierw wybieram główny cel strony. Dla artykułu będzie to zwykle Article lub BlogPosting, dla karty produktu Product, a dla strony głównej Organization. Dopiero później dokładam elementy uzupełniające, takie jak BreadcrumbList, autor czy film.
- Określ typ strony i wybierz odpowiadający mu typ danych w dokumentacji Google.
- Zbierz informacje widoczne dla użytkownika, na przykład tytuł, autora, datę publikacji, zdjęcie, cenę lub adres.
- Dodaj wymagane właściwości oraz tylko te rekomendowane, które możesz wypełnić prawdziwymi danymi.
- Wdróż markup, najlepiej jako JSON-LD generowany przez CMS, wtyczkę albo szablon strony.
- Przetestuj konkretny adres przed publikacją i po wdrożeniu zmian.
- Monitoruj raporty w Search Console, zwłaszcza po zmianie motywu, wtyczki lub systemu sklepowego.
Na blogu najczęściej potrzebujesz informacji o tytule, autorze, dacie publikacji, dacie modyfikacji, obrazie wyróżniającym i adresie kanonicznym. W sklepie dochodzą cena, waluta, stan magazynowy, identyfikator produktu, opinie oraz informacje o dostawie i zwrotach.
Wtyczka SEO może wygenerować podstawowy markup automatycznie, ale nie zakładałbym, że zrobi wszystko poprawnie. Częsty problem to podwójne oznaczenie tej samej strony przez motyw, wtyczkę i dodatkowy fragment kodu. Zamiast pomagać, taki zestaw tworzy sprzeczne informacje, na przykład dwóch autorów lub dwie różne daty publikacji.
Jeżeli dane powstają dynamicznie za pomocą JavaScriptu, trzeba sprawdzić, czy Google może je wyrenderować i odczytać. Przy szybko zmieniających się cenach i dostępności produktu bezpieczniejszym rozwiązaniem bywa generowanie danych po stronie serwera. Opóźnienie w aktualizacji markupu może prowadzić do prezentowania nieaktualnych informacji.
Jak testować i monitorować wdrożenie
Pierwszym narzędziem jest Rich Results Test. Pozwala sprawdzić, czy Google rozpoznaje określony typ danych, czy brakuje wymaganych właściwości i czy strona może kwalifikować się do wyniku rozszerzonego. Test nie daje jednak obietnicy, że dany element rzeczywiście pojawi się w wynikach.
Drugim miejscem jest Google Search Console. Raporty dotyczące wyników z elementami rozszerzonymi pokazują błędy, ostrzeżenia i prawidłowo odczytane podstrony. Po poprawkach warto użyć opcji walidacji, ale trzeba pamiętać, że ponowne przetworzenie strony może potrwać.
Rozróżniam trzy sytuacje, które często są ze sobą mylone:
- Błąd techniczny oznacza, że markup nie spełnia wymagań i może nie kwalifikować strony do wyniku rozszerzonego.
- Ostrzeżenie zwykle wskazuje brak zalecanej informacji, lecz nie zawsze blokuje kwalifikację.
- Poprawne dane oznaczają, że Google potrafi je odczytać, ale nie gwarantują wyświetlenia rozszerzenia.
Po wdrożeniu patrzę nie tylko na sam test, lecz także na wygląd strony i dane w Search Console. Jeśli sklep zmienił ceny, wpis został zaktualizowany albo usunięto kategorię, markup powinien odzwierciedlać tę zmianę. Najgorszy jest poprawny kod z nieaktualną treścią.
Najczęstsze błędy i realne ograniczenia
Najczęściej spotykam oznaczanie informacji, których nie ma w widocznej treści. Przykładem może być dodanie oceny 5,0 bez recenzji na stronie albo wpisanie autora, który nie został wskazany przy artykule. Takie praktyki nie budują zaufania i mogą pozbawić stronę kwalifikacji do rozszerzonego wyniku.
Drugim błędem jest dodawanie zbyt wielu typów bez logicznego powiązania. Artykuł może zawierać autora, breadcrumbs i dane organizacji, ale nie powinien być opisany jako produkt, wydarzenie i przepis tylko dlatego, że wszystkie te schematy są dostępne.
Nie należy też traktować danych strukturalnych jako bezpośredniego czynnika, który automatycznie podnosi pozycję. Ich główna korzyść polega na lepszym zrozumieniu i atrakcyjniejszej prezentacji wyniku. Jeżeli treść jest słaba, strona wolna, a informacje nieaktualne, sam markup niewiele zmieni.
W 2026 roku nie budowałbym strategii SEO wokół obietnicy, że każdy typ schema.org da dodatkowy element w SERP-ach. Google obsługuje tylko wybrane typy i może ograniczać albo zmieniać sposób ich wyświetlania. Dotyczy to także oznaczeń pytań i odpowiedzi, dlatego warto sprawdzać aktualną galerię funkcji Google zamiast kopiować stare poradniki.
Nie ma też specjalnych danych strukturalnych przeznaczonych wyłącznie dla AI Overviews czy AI Mode. Najrozsądniejsze podejście pozostaje proste: tworzyć pomocną treść, udostępniać ją robotom, dbać o tekstową wersję informacji i pilnować, by markup był zgodny z widoczną stroną.
Jak podejść do tematu bez przepalania czasu
Największą wartość zwykle daje uporządkowanie kluczowych szablonów, a nie ręczne poprawianie setek pojedynczych stron. Zacząłbym od strony głównej, artykułów generujących ruch, kart produktów i najważniejszych stron usługowych. Taki audyt szybko pokazuje, gdzie dane są dublowane, nieaktualne albo całkowicie nieobecne.
Jeśli masz mały blog, wystarczy poprawny Article, autor, data, obraz i BreadcrumbList. Jeśli prowadzisz sklep, większą uwagę poświęć cenom, dostępności, identyfikatorom produktów oraz dostawie. Priorytet powinien wynikać z modelu biznesowego strony, a nie z listy wszystkich możliwych typów.
Dobrze wdrożone dane strukturalne nie zastąpią strategii SEO, ale pomagają Google czytać stronę bez zgadywania. Właśnie dlatego warto traktować je jak uporządkowaną warstwę techniczną, którą raz projektujesz, a później regularnie kontrolujesz po zmianach w serwisie.