Strona może być świetnie napisana, a mimo to w wynikach wyszukiwania wyglądać jak przypadkowy fragment kodu. Dobrze ustawione meta tagi pomagają wyszukiwarce zrozumieć dokument, kontrolować indeksowanie i atrakcyjnie zaprezentować go użytkownikowi. Pokażę, które elementy HTML mają dziś znaczenie dla SEO, jak je wdrażać oraz których popularnych praktyk lepiej już nie stosować.
Najważniejsze informacje o metadanych strony
- Opis strony może poprawić atrakcyjność wyniku, ale Google nie zawsze wyświetla go w niezmienionej formie.
- Element title nie jest technicznie tagiem meta, lecz pozostaje jednym z najważniejszych elementów widocznych w wyszukiwarce.
- Robots pozwala określić, czy strona ma być indeksowana i czy wyszukiwarka może pokazywać jej fragment.
- Canonical wskazuje preferowany adres podobnych lub zduplikowanych wersji treści, choć nie jest klasycznym tagiem meta.
- Open Graph odpowiada głównie za wygląd udostępnianej strony w mediach społecznościowych.
Czym są meta tagi i gdzie umieszcza się je w HTML
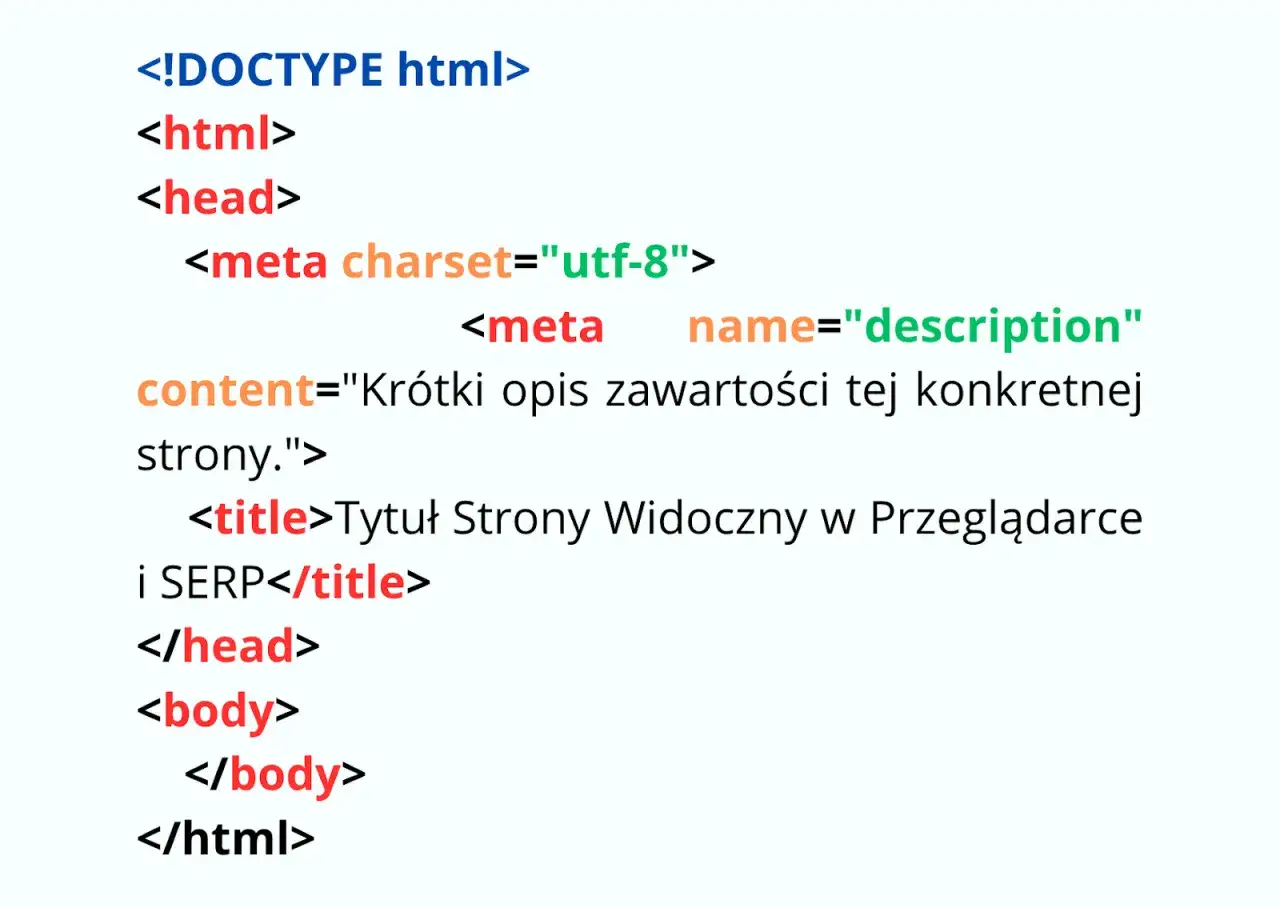
Meta tag to element HTML przekazujący informacje o stronie, których zwykle nie widać bezpośrednio w jej treści. Umieszcza się go najczęściej w sekcji , czyli w części dokumentu przeznaczonej dla ustawień, tytułu, arkuszy stylów i danych technicznych.
Najprostszy przykład wygląda tak:
Atrybut name określa rodzaj informacji, a content zawiera jej wartość. W przypadku kodowania dokumentu stosuje się osobny zapis z atrybutem charset, natomiast dyrektywy dla robotów korzystają z nazwy robots.
W praktyce branżowej do metadanych zalicza się też elementy, które nie są tagami . Dotyczy to przede wszystkim . Techniczna klasyfikacja ma znaczenie, gdy pracuję z kodem, ale dla właściciela strony ważniejszy jest efekt: jak dokument zostanie odczytany, zindeksowany i pokazany użytkownikowi.
Nie każdy element w sekcji daje bezpośredni wzrost pozycji. Część wpływa na indeksowanie, część na wygląd wyniku, a część na udostępnianie treści. To rozróżnienie chroni przed częstym błędem polegającym na traktowaniu każdego wpisu jako „sekretnego czynnika rankingowego”.
Które elementy mają największe znaczenie dla SEO
Na co dzień zaczynam od kilku podstawowych elementów, bo to one najczęściej decydują o jakości technicznej strony. Poniższa tabela pokazuje ich funkcję i realne zastosowanie.
| Element | Do czego służy | Znaczenie praktyczne |
|---|---|---|
|
Definiuje tytuł dokumentu i często tytuł wyniku w Google. | Wysokie. Każda ważna podstrona powinna mieć własny, opisowy tytuł. |
description |
Przekazuje krótki opis zawartości strony. | Wpływa głównie na komunikat i potencjalną klikalność wyniku. |
robots |
Przekazuje zasady indeksowania i prezentowania treści. | Wysokie na stronach, które mają pozostać poza indeksem. |
charset |
Określa kodowanie znaków, najczęściej UTF-8. | Techniczne, ale podstawowe dla poprawnego wyświetlania polskich znaków. |
viewport |
Pomaga przeglądarce dopasować widok do urządzenia. | Istotne dla użyteczności mobilnej, choć nie opisuje treści strony. |
og:title i og:description
|
Ustalają dane widoczne przy udostępnianiu strony. | Ważne dla ruchu z mediów społecznościowych i komunikatorów. |
Tytuł dokumentu
Element
Meta tagi w SEO - praktyczny poradnik HTML Dobry tytuł powinien być unikalny, konkretny i zgodny z zawartością. Nie próbuję upychać w nim kilku podobnych fraz. Lepiej napisać „Jak ustawić meta description i robots w HTML” niż tworzyć ciąg słów bez jasnej obietnicy dla czytelnika.
Opis strony
Opis przekazywany przez description może pojawić się pod tytułem w wynikach wyszukiwania. Google nie gwarantuje jednak jego wyświetlenia. Jeśli uzna, że inny fragment treści lepiej odpowiada zapytaniu, może wygenerować własny snippet.
Nie istnieje jedna sztywna długość, która gwarantuje poprawne wyświetlenie opisu na każdym urządzeniu. Ja zwykle celuję w około 120-160 znaków, ale traktuję ten zakres jako praktyczną wskazówkę, nie normę. Najważniejsze jest zawarcie konkretnej korzyści, tematu strony i naturalnego wezwania do działania.
Jak poprawnie ustawić metadane krok po kroku
Najłatwiej wdrożyć je według kolejności, która ogranicza ryzyko pomyłek. Nie zaczynam od dodatków społecznościowych. Najpierw sprawdzam, czy podstawowa wersja dokumentu jest jednoznaczna dla przeglądarki i wyszukiwarki.
- Ustaw kodowanie UTF-8, aby polskie znaki i symbole były odczytywane poprawnie.
- Dodaj unikalny title dopasowany do konkretnej podstrony.
- Napisz opis, który zachęca do wejścia, ale nie obiecuje treści, której na stronie nie ma.
- Sprawdź viewport, szczególnie w serwisie responsywnym.
- Dodaj robots tylko wtedy, gdy jest potrzebny. Brak tego wpisu zwykle nie oznacza problemu, ponieważ domyślnym zachowaniem jest możliwość indeksowania.
- Zweryfikuj canonical, jeśli strona ma warianty z parametrami, filtrowaniem lub podobną treścią.
Audyt SEO strony internetowej - najważniejsze elementy
W systemie WordPress większość tych pól uzupełnia się przez wtyczkę SEO albo ustawienia motywu. Mimo to zawsze zaglądam do wygenerowanego kodu źródłowego. Wtyczka może tworzyć duplikaty, dodawać nieaktualne wartości albo pobierać zły fragment tekstu z szablonu.
Po wdrożeniu sprawdzam kilka reprezentatywnych podstron, a nie tylko stronę główną. Artykuł, produkt, kategoria i strona kontaktowa często korzystają z innych szablonów, więc jeden poprawiony wpis nie potwierdza poprawności całej witryny.
Robots, canonical i Open Graph rozwiązują różne problemy
Te elementy bywają wrzucane do jednego worka, choć mają zupełnie inne zadania. Dobre ustawienia wynikają nie z kopiowania gotowego zestawu, lecz z odpowiedzi na pytanie, co ma stać się z konkretną stroną.
Robots kontroluje indeksowanie
Wartość noindex informuje, że strona nie powinna trafić do indeksu. Z kolei follow odnosi się do możliwości podążania za linkami. Taki zapis bywa przydatny przy stronach podziękowania, wewnętrznych wynikach wyszukiwania, testowych landing page’ach i wybranych filtrach.
Nie dodaję noindex „na wszelki wypadek”. Jeśli użyjesz go na wartościowym artykule, możesz wyłączyć stronę z wyników. Trzeba też pamiętać, że blokada w pliku robots.txt może uniemożliwić robotowi odczytanie dyrektywy, dlatego oba mechanizmy nie są zamiennymi sposobami kontroli indeksowania.
Canonical porządkuje podobne adresy
Canonical wskazuje preferowaną wersję adresu spośród stron identycznych lub bardzo podobnych. Nie jest twardym rozkazem dla wyszukiwarki, lecz silnym sygnałem. Google może go zignorować, jeśli inne sygnały, takie jak przekierowania, linkowanie wewnętrzne lub zawartość, wskazują inną wersję.
Najczęstszy błąd polega na ustawieniu jednego canonicala na wszystkich podstronach. Każdy dokument powinien wskazywać właściwy adres dla siebie, a nie automatycznie adres strony głównej. W sklepie internetowym szczególnej uwagi wymagają parametry sortowania, filtrowanie i warianty produktów.
Przeczytaj również: Słowo kluczowe w SEO - jak dobrać frazy do treści?
Open Graph odpowiada za udostępnienia
Open Graph nie służy przede wszystkim do sterowania indeksowaniem. Określa, jaki tytuł, opis i obraz zobaczy osoba, która udostępni stronę na platformie obsługującej ten standard. W praktyce poprawne dane społecznościowe ograniczają problem losowych miniaturek i urwanych tytułów.
Nie traktuję ich jako zamiennika opisu SEO. Meta description i Open Graph mają podobne pola, ale inne zastosowanie. Można wykorzystać podobny tekst, jednak nie ma obowiązku kopiowania go znak w znak.
Najczęstsze błędy, które obniżają jakość wdrożenia
Największe problemy zwykle nie wynikają z braku egzotycznego znacznika, lecz z niedokładności w podstawach. W audytach powtarzają się te same sytuacje.
- Duplikaty title i description na wielu podstronach utrudniają odróżnienie ich tematyki.
- Puste wartości sprawiają, że wynik może otrzymać przypadkowy tytuł lub opis.
- Przesadne obietnice zwiększają ryzyko szybkiego opuszczenia strony po wejściu.
- Upychanie słów kluczowych pogarsza czytelność i nie zastępuje dobrej treści.
- Przypadkowe noindex może usunąć z wyników stronę, która miała generować ruch.
- Błędny canonical może wskazać wyszukiwarce inną wersję niż ta, którą chcemy promować.
- Brak kontroli nad szablonem prowadzi do dopisywania nazwy serwisu, kategorii lub daty w niewłaściwym miejscu.
Osobno traktuję dawny tag keywords. Współczesne wyszukiwarki nie wykorzystują go jako istotnego sygnału rankingowego, więc poświęcanie czasu na jego uzupełnianie nie ma sensu. Lepiej przeznaczyć te kilka minut na poprawę tytułu, śródtytułów i pierwszego akapitu.
Nie przywiązuję też dużej wagi do narzuconych limitów znaków. Narzędzia SEO często pokazują zielone i czerwone paski, ale wyszukiwarka prezentuje tekst zależnie od urządzenia, szerokości znaków i zapytania. Limit jest wskazówką redakcyjną, a nie gwarancją widoczności całego tekstu.
Jak sprawdzić, czy wszystko działa po wdrożeniu
Sam zapis w kodzie nie wystarczy. Weryfikuję zarówno to, co widzi przeglądarka, jak i to, co może odczytać robot. Dzięki temu łatwiej odróżnić błąd HTML od sytuacji, w której wyszukiwarka świadomie wybrała inny tytuł lub opis.
- Otwórz źródło strony i wyszukaj
descriptionorazrobots. - Sprawdź, czy każda wartość dotyczy właściwej podstrony.
- Zweryfikuj, czy nie ma dwóch tytułów, dwóch opisów albo kilku canonicali.
- Przetestuj stronę na telefonie i komputerze.
- Użyj narzędzi do kontroli indeksowania i sprawdź, czy adres nie jest przypadkowo wykluczony.
- Po publikacji obserwuj wygląd wyniku i zmieniaj tekst dopiero po zebraniu danych.
Zmiana tytułu lub opisu nie zawsze pojawi się w wynikach natychmiast. Google musi ponownie odwiedzić i przetworzyć stronę, a wyświetlany fragment może nadal zostać dobrany automatycznie. Dlatego nie oceniam efektu po kilku minutach ani nie zakładam, że każda modyfikacja wpłynie bezpośrednio na pozycję.
Najlepszy test jest prosty: porównuję, czy tytuł odpowiada intencji, opis zachęca do kliknięcia, a treść po wejściu spełnia obietnicę. Metadane mają pomagać użytkownikowi podjąć decyzję, nie tylko wyglądać poprawnie w panelu wtyczki.
Małe poprawki w kodzie, które budują większą spójność SEO
Jeśli mam ograniczony czas, zaczynam od stron, które już pojawiają się w wynikach, ale mają niski współczynnik klikalności. Poprawa tytułu i opisu na takich adresach często daje szybszy sygnał niż tworzenie kolejnych wpisów bez uporządkowania istniejących.
Na końcu sprawdzam jeszcze spójność między tytułem, H1, adresem URL, opisem i faktyczną treścią. Gdy wszystkie te elementy mówią o tym samym, wyszukiwarka i czytelnik dostają jasny komunikat. To właśnie ta konsekwencja, a nie liczba dodanych znaczników, robi największą różnicę.