Masz wartościowy poradnik, produkt albo landing page, ale użytkownicy i roboty Google trafiają na niego wyłącznie z bezpośredniego adresu? W SEO termin orphan pages oznacza strony osierocone, czyli takie, do których nie prowadzi żaden link z innej podstrony tego samego serwisu. Wyjaśniam, skąd się biorą, jak je wykryć oraz kiedy lepiej je podlinkować, połączyć z inną treścią albo usunąć.
Najważniejsze decyzje dotyczące stron osieroconych
- Strona osierocona nie ma żadnego wewnętrznego linku przychodzącego.
- Mapa XML nie zastępuje linkowania, choć może pomóc Google odkryć adres.
- Do wykrywania problemu trzeba porównać crawl serwisu, sitemapę, dane z Search Console i analitykę.
- Najczęściej najlepszą naprawą jest naturalny link z powiązanej treści.
- Nie każdą taką stronę należy ratować. Czasem właściwą decyzją będzie 301, noindex albo usunięcie.
Czym są strony osierocone i dlaczego mają znaczenie
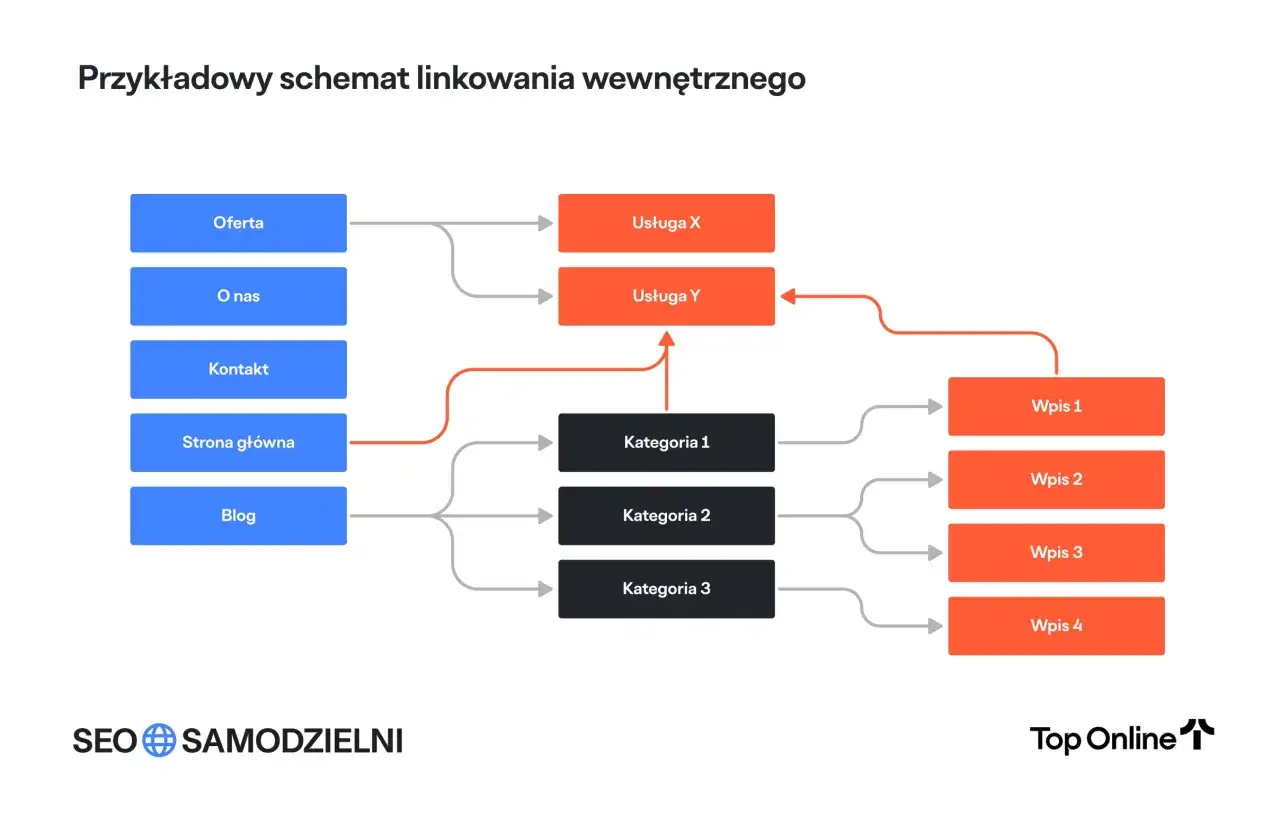
Strona osierocona istnieje pod konkretnym adresem, ale nie da się do niej przejść z żadnej innej indeksowalnej podstrony za pomocą linku wewnętrznego. Może znajdować się w mapie XML, być dostępna z wyników Google albo mieć linki z innych domen, ale z perspektywy struktury serwisu pozostaje odłączona od reszty witryny.
To ważne, bo linki pełnią dwie funkcje. Pomagają użytkownikowi poruszać się po stronie, a robotom wyszukiwarek odkrywać adresy i rozumieć relacje między treściami. Google Search Central wskazuje, że każda ważna podstrona powinna być osiągalna przynajmniej z jednej innej strony serwisu, najlepiej przez zwykły element HTML z atrybutem href.
Brak linków nie oznacza automatycznie, że strona nie zostanie zaindeksowana. Robot może znaleźć ją przez sitemapę, link zewnętrzny, przekierowanie lub wcześniej zapisany adres. Problem polega na czymś innym: taka podstrona dostaje mniej kontekstu, słabszą widoczność w architekturze informacji i często mniej wewnętrznych sygnałów niż podobne treści prawidłowo włączone do serwisu.
W praktyce szczególnie szkoda stron osieroconych, które już mają ruch, linki zewnętrzne, konwersje albo wartościową treść. Zdarza mi się znajdować poradniki generujące wejścia z Google, do których nie prowadzi ani jeden artykuł. To zwykle nie jest problem jakości samej treści, tylko zaniedbanego połączenia jej z resztą witryny.
Skąd biorą się odłączone podstrony
Najczęściej nie powstają w wyniku jednego dużego błędu. Są skutkiem drobnych zmian wykonywanych w różnych momentach przez redakcję, marketing, programistów i właściciela serwisu.
Zmiana struktury witryny
Podczas migracji CMS-a, przebudowy menu albo zmiany kategorii część starych linków znika. Adres pozostaje aktywny, lecz prowadzące do niego odnośniki zostają usunięte. Podobny efekt daje przeniesienie wpisu do nowej kategorii bez sprawdzenia, czy nadal pojawia się na stronie kategorii.
Landing page używany tylko w kampanii
Strony tworzone pod reklamy, newslettery lub krótkie akcje promocyjne często nie trafiają do menu ani sekcji bloga. Jeśli kampania się kończy, adres nadal może być indeksowany i odwiedzany z wyszukiwarki, mimo że nikt już nie pamięta o jego istnieniu.
Błędy w publikacji i automatyzacji
Niektóre systemy publikują stronę, ale nie dodają jej do kategorii, tagów ani modułu „powiązane artykuły”. Czasem winny jest filtr, który ukrywa wpisy starsze niż określona liczba dni. W sklepach problem mogą tworzyć produkty wycofane z kategorii, lecz nadal dostępne pod starym adresem.
Usunięcie linków prowadzących
Redaktorzy często aktualizują starsze teksty i kasują odnośniki do materiałów, które wydają się nieaktualne. Jeśli wszystkie takie linki znikną, strona docelowa może zostać sierotą. Dlatego przy większej aktualizacji treści sprawdzam nie tylko linki wychodzące, ale też to, czy usuwany odnośnik nie był jedynym połączeniem z ważną podstroną.
Jak znaleźć strony osierocone krok po kroku
Pojedynczy crawl nie zawsze wystarczy. Narzędzie analizujące wyłącznie linki znalezione na stronie nie wykryje adresu, do którego nie prowadzi żaden link. Potrzebne jest porównanie kilku źródeł, czyli zbudowanie listy wszystkich znanych URL-i i odjęcie od niej adresów odkrytych przez linkowanie wewnętrzne.
- Przeskanuj serwis crawlerem i wyeksportuj adresy z zerową liczbą linków przychodzących.
- Dodaj adresy z sitemap XML, ponieważ mogą obejmować strony niewidoczne w menu i treści.
- Sprawdź Search Console, zwłaszcza strony z wyświetleniami, kliknięciami lub historią indeksowania.
- Porównaj dane z analityki, aby znaleźć adresy odwiedzane przez użytkowników mimo braku linków wewnętrznych.
- Uwzględnij bazę CMS-a, katalog produktów, stare landing page i adresy po migracjach.
Najcenniejsze są nie wszystkie znalezione adresy, ale ich priorytety. Strona z ruchem organicznym, konwersjami lub dobrymi linkami zewnętrznymi wymaga szybkiej decyzji. Adres testowy, pusty filtr sklepu albo techniczna wersja pliku może zostać wykluczony bez przebudowy całej architektury.
| Źródło danych | Co może ujawnić | Na co uważać |
|---|---|---|
| Crawler | Adresy bez linków z aktualnie skanowanych stron | Nie wykryje wszystkiego, jeśli nie połączysz go z innymi źródłami |
| Sitemap XML | Adresy zgłoszone wyszukiwarce | Może zawierać stare, błędne lub nieprzeznaczone do indeksowania URL-e |
| Search Console | Strony odkryte, indeksowane i odwiedzane z Google | Nie pokazuje pełnej mapy linków wewnętrznych |
| Analityka | Adresy, które faktycznie odwiedzają użytkownicy | Ruch może pochodzić z reklamy, zakładki lub linku zewnętrznego |
| CMS i baza produktów | Strony istniejące technicznie, lecz niewidoczne w nawigacji | Trzeba odróżnić aktywne treści od wersji roboczych i archiwalnych |
Przed oznaczeniem adresu jako problematycznego sprawdzam jeszcze status HTTP, tag canonical, dyrektywę noindex i wersję mobilną. Narzędzie może zgłosić fałszywego „sierotę”, jeśli nie renderuje linków dodawanych przez JavaScript albo jeśli osobno traktuje warianty adresu z parametrami.
Co zrobić ze znalezioną stroną
Nie zaczynam od masowego dodawania linków. Najpierw oceniam, czy dana podstrona zasługuje na miejsce w strukturze witryny. Dobra decyzja zależy od jej jakości, celu biznesowego, ruchu i tego, czy nie kanibalizuje innej treści.
Dodaj link, gdy strona nadal jest potrzebna
Jeśli materiał odpowiada na realne pytanie odbiorcy, znajdź dla niego jedno lub kilka logicznych miejsc wejścia. Link może pojawić się w powiązanym artykule, stronie kategorii, poradniku zbiorczym, opisie usługi albo sekcji produktów. Anchor powinien informować, co użytkownik znajdzie po kliknięciu, zamiast ograniczać się do „czytaj więcej”.
Nie chodzi o to, by zdobyć określoną liczbę linków. Jeden mocny, kontekstowy odnośnik z dobrze dopasowanej strony bywa cenniejszy niż kilkanaście automatycznych linków z przypadkowych modułów. Zawsze sprawdzam też, czy podstrona jest dostępna w wersji mobilnej i czy link działa bez konieczności uruchamiania dodatkowej akcji.
Połącz treści, gdy strony odpowiadają na to samo pytanie
Jeśli strona osierocona powiela istniejący artykuł, samo linkowanie może tylko zwiększyć bałagan. W takiej sytuacji lepiej wybrać mocniejszą wersję, przenieść do niej unikalne informacje i zastosować przekierowanie 301. To rozwiązanie ogranicza rozproszenie sygnałów i upraszcza ścieżkę użytkownika.
Przeczytaj również: Jak sprawdzić pozycję strony w Google i dobrze czytać dane?
Usuń albo wyklucz, gdy adres nie ma wartości
Strony testowe, puste wyniki wyszukiwania, zakończone akcje i nieaktualne produkty nie muszą być ratowane. W zależności od sytuacji stosuje się usunięcie z kodem 404 lub 410, przekierowanie do najbliższego odpowiednika albo noindex. Samo ukrycie strony w menu nie rozwiązuje problemu, jeśli adres nadal jest dostępny i znajduje się w sitemapie.
Unikam kierowania wszystkich niepotrzebnych adresów na stronę główną. Takie przekierowanie często nie odpowiada intencji użytkownika i może zostać potraktowane jako miękki błąd 404. Lepszy jest najbliższy tematycznie odpowiednik albo świadome usunięcie adresu.
Jak projektować linkowanie, żeby problem nie wracał
Najprostsza zasada brzmi: każda ważna strona powinna mieć jasno określone miejsce w strukturze. Dla wpisu będzie to zwykle kategoria, artykuł nadrzędny i kilka powiązanych materiałów. Dla produktu mogą to być kategoria, podkategoria, produkty podobne i poradnik zakupowy.
W blogu dobrze działają strony hubowe, czyli rozbudowane przewodniki zbierające linki do mniejszych tematów. Taki układ pomaga użytkownikowi przejść od ogólnego zagadnienia do szczegółowej odpowiedzi, a robotowi zrozumieć hierarchię treści. Nie trzeba budować skomplikowanej struktury. Ważniejsze jest to, by połączenia wynikały z tematu, a nie z automatycznego szablonu.
Kontroluję również głębokość kliknięć. Ważna podstrona oddalona o sześć lub siedem przejść od strony głównej może być formalnie osiągalna, ale praktycznie trudna do znalezienia. Dla kluczowych treści dążę do krótkiej ścieżki, najlepiej do trzech lub czterech kliknięć, choć nie traktuję tej liczby jako sztywnej normy dla każdego serwisu.
- Linkuj z treści, które mają podobny temat i własny ruch.
- Używaj anchorów opisujących zawartość strony docelowej.
- Nie opieraj całej nawigacji na filtrach, przyciskach i skryptach.
- Po migracji wykonaj ponowny crawl i porównaj stare oraz nowe adresy.
- Przy publikacji nowego tekstu od razu wskaż mu kategorię i co najmniej jedno miejsce linkowania.
Mapa XML nadal jest przydatna, szczególnie w dużych, nowych lub często zmienianych serwisach. Nie traktuję jej jednak jako zamiennika architektury informacji. Sitemap pomaga wyszukiwarce odkrywać adresy, ale nie gwarantuje crawlowania, indeksowania ani wysokiej pozycji.
Błędy, które utrudniają naprawę stron osieroconych
Pierwszy błąd to ślepe zaufanie raportowi jednego narzędzia. Każdy crawler ma własny sposób liczenia linków, obsługi JavaScriptu, kanonicznych adresów i parametrów. Wynik trzeba zestawić z rzeczywistą strukturą strony oraz danymi o ruchu.
Drugi błąd to masowe dodawanie linków w stopce, sidebarze albo module „popularne”. Taki zabieg może formalnie usunąć problem zerowej liczby linków, ale nie poprawi znacząco użyteczności. Wewnętrzne linkowanie powinno odpowiadać na pytanie, dlaczego użytkownik ma przejść właśnie do tej treści.
Trzeci błąd polega na ratowaniu każdej podstrony. Czasem właściciel serwisu spędza godziny na przywracaniu linków do artykułów, które są przestarzałe, krótkie i nie mają żadnego celu. Audyt ma prowadzić do lepszej struktury, a nie do utrzymywania każdego historycznego URL-a za wszelką cenę.
Nie zakładam też, że wzrost widoczności nastąpi natychmiast po dodaniu odnośników. Efekt zależy od częstotliwości crawlowania, jakości treści, konkurencji i historii domeny. Po wdrożeniu zmian monitoruję indeksowanie, kliknięcia, pozycje oraz zachowanie użytkowników przez kilka tygodni, zamiast oceniać rezultat po dwóch dniach.
Jak zamienić audyt w stały element pracy nad SEO
Strony osierocone najlepiej kontrolować cyklicznie, zwłaszcza po migracji, zmianie menu, dużej aktualizacji kategorii albo wdrożeniu nowego systemu publikacji. W małym blogu wystarczy przegląd raz na kwartał, a w sklepie lub rozbudowanym portalu sensownie jest sprawdzać strukturę co miesiąc.
Najpraktyczniejszy raport powinien zawierać adres, typ strony, liczbę linków przychodzących, ruch organiczny, konwersje, status indeksowania i rekomendowane działanie. Taka lista szybko pokazuje, które adresy są realną szansą na poprawę SEO, a które tylko technicznym odpadem.
Moja końcowa zasada jest prosta. Nie pytam wyłącznie, czy robot może znaleźć daną stronę, lecz także czy człowiek ma dobry powód, aby do niej trafić. Jeśli odpowiedź brzmi „tak”, dodaję naturalne połączenie w odpowiednim miejscu. Jeśli nie, porządkuję serwis przez konsolidację, przekierowanie albo usunięcie zbędnego adresu.