Nowa strona może działać bez zarzutu, a mimo to długo nie pojawiać się w wynikach wyszukiwania. Proces indeksowania strony w Google obejmuje kilka etapów, dlatego samo opublikowanie adresu nie zawsze wystarcza. Pokażę, jak sprawdzić obecność witryny w indeksie, zgłosić nowe podstrony, usunąć typowe blokady i ocenić, kiedy problem leży nie w technice, lecz w jakości treści.
Najważniejsze informacje o widoczności strony w Google
- Indeksowanie nie oznacza jeszcze wysokiej pozycji w wynikach wyszukiwania.
- Google najpierw musi odnaleźć i pobrać adres URL, a dopiero później ocenia jego zawartość.
- Najpraktyczniejszym narzędziem diagnostycznym jest Google Search Console i funkcja inspekcji adresu URL.
- Mapa witryny, linkowanie wewnętrzne i poprawna konfiguracja techniczna ułatwiają odkrycie podstron.
- Brak indeksacji często powodują noindex, robots.txt, błędy serwera, duplikaty albo bardzo słaba treść.
Jak Google odnajduje i dodaje stronę do indeksu
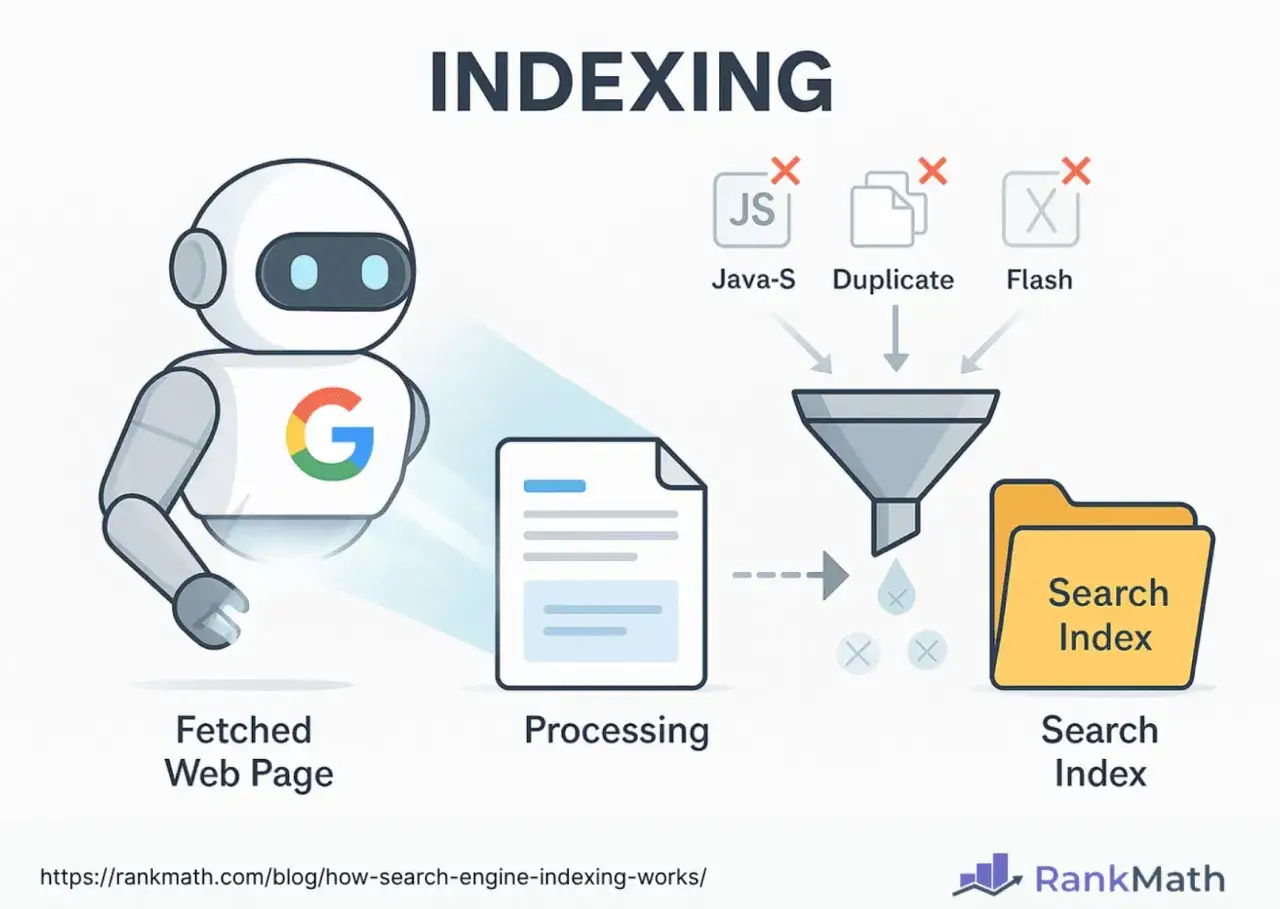
Google działa w trzech powiązanych etapach. Najpierw robot, zwykle nazywany Googlebotem, odkrywa adres URL. Później pobiera stronę i analizuje jej zawartość. Dopiero na końcu podejmuje decyzję, czy przechować ją w swoim indeksie i wykorzystać przy dopasowywaniu wyników.
Crawlowanie nie jest tym samym co indeksowanie
Crawlowanie oznacza pobranie strony przez robota. Adres może zostać odwiedzony, ale nie musi trafić do indeksu. Indeksowanie to osobna decyzja, podczas której Google analizuje między innymi tekst, nagłówki, obrazy, linki, metadane, wersję kanoniczną i przydatność strony.
Nowy adres może zostać znaleziony przez link z innej podstrony, mapę witryny albo wcześniej znaną strukturę serwisu. Z mojego doświadczenia wynika, że dobrze rozmieszczone linki wewnętrzne są często skuteczniejsze niż samo wielokrotne wysyłanie prośby o indeksację.
Renderowanie ma znaczenie przy JavaScript
Jeżeli treść pojawia się dopiero po wykonaniu JavaScriptu, Google musi ją dodatkowo wyrenderować. Nowoczesne rozwiązania są obsługiwane, ale błędy w aplikacji, opóźnione ładowanie danych albo treść dostępna wyłącznie po kliknięciu mogą sprawić, że robot zobaczy mniej niż użytkownik.
Najbezpieczniej jest umieszczać najważniejsze informacje w kodzie HTML dostępnych bez dodatkowych działań. Widoczność treści w przeglądarce nie gwarantuje, że Google odczyta ją w identyczny sposób.
Przeczytaj również: Przekierowanie 301 w .htaccess bez pętli i spadków widoczności
Indeksacja nie gwarantuje pozycji
Zaindeksowana strona może nie pojawiać się wysoko, a czasem nie będzie widoczna dla konkretnego zapytania. Indeks mówi tylko, że Google przechowuje informacje o adresie. O pozycji decydują później między innymi trafność, jakość, konkurencja, doświadczenie użytkownika i kontekst zapytania.
Jak sprawdzić, czy podstrona jest w Google
Najdokładniejszą diagnozę wykonuję w Google Search Console. Po dodaniu i zweryfikowaniu właściwości należy użyć narzędzia Sprawdzanie adresu URL. W kilka chwil można zobaczyć, czy adres znajduje się w indeksie, czy Google może go pobrać oraz czy wykryto problemy z kanoniczną wersją strony.
Jeśli podstrona jest gotowa, ale nie została jeszcze odwiedzona, można wybrać opcję poproszenia o zindeksowanie. To sygnał dla Google, a nie gwarancja natychmiastowego efektu. W praktyce ponawianie tej samej prośby kilka razy pod rząd zwykle niczego nie przyspiesza.
Pomocniczo można użyć operatora site: i sprawdzić, czy domena lub konkretny fragment witryny pojawia się w wynikach. Trzeba jednak traktować tę metodę orientacyjnie, ponieważ lista wyników nie musi pokazywać wszystkich zaindeksowanych adresów.
Czas oczekiwania bywa różny. Nowa, mała podstrona może zostać odwiedzona po kilku dniach, ale przy większym serwisie albo słabych sygnałach odkrywania proces może potrwać dłużej. Google nie obiecuje konkretnego terminu indeksacji, dlatego najważniejsze jest usunięcie przeszkód technicznych i zapewnienie stronie realnej wartości.
Co zrobić, aby ułatwić Google indeksowanie
Nie istnieje jeden przycisk, który zapewni widoczność całej witryny. Można jednak uporządkować proces w kilku praktycznych krokach. Ja zaczynam od sprawdzenia dostępności, a dopiero później przechodzę do zgłaszania adresów.
- Zweryfikuj domenę w Google Search Console. Dzięki temu otrzymasz dane o indeksacji, błędach i sposobie, w jaki Google widzi poszczególne adresy.
- Dodaj aktualną mapę witryny XML. Sitemap pomaga wskazać ważne adresy, szczególnie po uruchomieniu nowej strony lub dużej przebudowie serwisu.
- Zadbaj o linkowanie wewnętrzne. Nowy artykuł powinien być połączony z kategorią, stroną tematyczną albo inną już znaną podstroną.
- Sprawdź plik robots.txt. Nie powinien blokować ważnych sekcji, zasobów ani całych katalogów przypadkowym wpisem.
- Skontroluj tag noindex. Meta robots z wartością noindex wyraźnie mówi wyszukiwarce, aby nie umieszczała strony w indeksie.
- Opublikuj użyteczną treść. Tekst powinien odpowiadać na konkretne pytanie, wnosić coś własnego i nie być mechaniczną kopią innych stron.
- Poproś o ponowne sprawdzenie po większej zmianie. Ma to sens po aktualizacji ważnego artykułu, zmianie adresu lub usunięciu problemu technicznego.
Sama mapa witryny nie podnosi pozycji i nie wymusza indeksacji. Jej rola jest prostsza, ale ważna: pomaga Google odkryć adresy. Podobnie zgłoszenie w Search Console nie zastępuje dobrej architektury serwisu ani wartościowej zawartości.
Dlaczego Google nie indeksuje strony
Brak adresu w indeksie nie zawsze oznacza awarię. Czasami witryna jest świeża, podstrona ma bardzo mało treści albo Google uznaje ją za duplikat innego adresu. Poniższe zestawienie pomaga zawęzić przyczynę.
| Problem | Co sprawdzić | Co poprawić |
|---|---|---|
| Blokada w robots.txt | Czy katalog lub adres nie jest objęty regułą Disallow | Usuń blokadę, jeśli strona ma być dostępna dla Google |
| Tag noindex | Kod HTML i ustawienia CMS | Wyłącz noindex na stronie przeznaczonej do wyników |
| Duplikat treści | Adres kanoniczny i podobne podstrony | Wybierz główną wersję i uporządkuj canonicale |
| Błąd serwera | Kody 4xx, 5xx, przekierowania i dostępność hostingu | Napraw odpowiedzi serwera oraz błędne przekierowania |
| Brak linków | Czy podstrona jest połączona z resztą serwisu | Dodaj naturalne linki z kategorii i powiązanych artykułów |
| Słaba lub pusta zawartość | Unikalność, kompletność i użyteczność tekstu | Rozbuduj stronę o konkretne informacje, przykłady i odpowiedzi |
| Problemy z JavaScript | Widok wyrenderowany i kod źródłowy | Udostępnij kluczową treść w sposób możliwy do odczytania bez interakcji |
Najczęstsza pomyłka dotyczy robots.txt. Ten plik może ograniczyć crawlowanie, ale sam w sobie nie jest właściwym sposobem usuwania strony z wyników. Jeśli chcesz zablokować indeksowanie, stosuje się noindex albo ochronę dostępu, a nie przypadkowe ukrywanie adresu przed robotem.
Problemem bywają też adresy z parametrami, filtrowaniem i sortowaniem. Sklep internetowy może w ten sposób tworzyć setki niemal identycznych URL-i. W takim przypadku trzeba wskazać wersje kanoniczne i zdecydować, które warianty naprawdę zasługują na indeks.
Jak monitorować indeksację po wdrożeniu zmian
Jednorazowa kontrola nie wystarczy, szczególnie gdy witryna regularnie publikuje nowe materiały. W Search Console sprawdzam raport dotyczący indeksowania, mapę witryny, przykładowe adresy oraz komunikaty o błędach. Dzięki temu można odróżnić pojedynczy problem z artykułem od awarii obejmującej cały serwis.
Przy większej stronie warto obserwować także statystyki skanowania i obciążenie serwera. Jeżeli hosting często zwraca błędy albo odpowiada z dużym opóźnieniem, Google może ograniczyć częstotliwość odwiedzin. Stabilny serwer jest warunkiem technicznym, którego nie zastąpi nawet najlepiej przygotowana mapa XML.
Po publikacji nowego tekstu sprawdzam trzy rzeczy: czy adres działa bez logowania, czy prowadzi do niego link wewnętrzny i czy strona nie ma przypadkowego noindex. Dopiero potem wysyłam prośbę o sprawdzenie. Taka kolejność oszczędza czas, bo nie zgłaszam wielokrotnie adresu, który nadal ma ten sam błąd.
Warto też pamiętać o wersjach językowych i regionalnych. Polski tekst powinien mieć spójny język, tytuł, nagłówki i dane o lokalizacji. Sama domena z końcówką .pl nie gwarantuje widoczności w Polsce, ale dobrze dopasowana treść i jasne sygnały lokalne pomagają Google zrozumieć, dla kogo powstała strona.
Co sprawdzić przed publikacją kolejnej podstrony
Najprostsza kontrola wygląda tak: otwórz adres w trybie bez logowania, upewnij się, że strona zwraca prawidłową odpowiedź, sprawdź obecność wartościowej treści i dodaj link z istniejącej części serwisu. Potem zweryfikuj canonical, meta robots oraz obecność adresu w mapie witryny.
Jeżeli wszystko się zgadza, zgłoszenie adresu w Search Console może pomóc Google szybciej go odkryć. Nie traktowałbym go jednak jako magicznego przyspieszacza. Największą różnicę robi połączenie dostępności technicznej, logicznej struktury i treści, która rzeczywiście zasługuje na miejsce w indeksie.